(西雅图17日讯)上周,美国办公软件巨头——微软(Microsoft)系统发生故障,旗下多个生产力工具陆续出现问题,最终导致全球大当机。然而,外媒报导揭露,导致软体瘫痪的漏洞早在7月就一直潜伏在微软的数据中心中,却没有被发现。
外媒报道,上周三(11日),微软对用户流量进行例行重新导向时,系统发生了故障。随后,其微软的各式软件与功能如Outlook、Teams、人工智能(AI)助理Copilot和其它几项服务的关键伺服器开始出现故障,最终导致全球各地的人们服务中断。
在接下来的15小时内,尽管伺服器出现零星故障,但微软似乎没有意识到更大的问题正在酝酿。该公司在周日(15日)向客户发布的初步报告证实了这一点。此后,微软又花了15个小时来确定,并开始推出修复程式。
对于严重依赖微软软件的全球网络世界来说,这是相当漫长的等待。
反应慢半拍
上周三,美国东岸时间晚上8点刚过,微软Teams视讯会议和聊天服务的流量会自动重新导向到处理Outlook流量的独立伺服器系统。加上本周稍早因无关问题导致的伺服器容量损失,触发了这一漏洞,导致伺服器在流量意外激增后耗尽记忆体。
伺服器开始故障,更糟的是,自动化系统会把电子邮件和使用者流量重新导向到微软系统认定的“正常伺服器”上,导致漏洞也出现在其它伺服器。到美东时间上周四(12日)上午11点30分,正值美国商业流量达到高峰之际,微软才意识到自己遇到了问题。
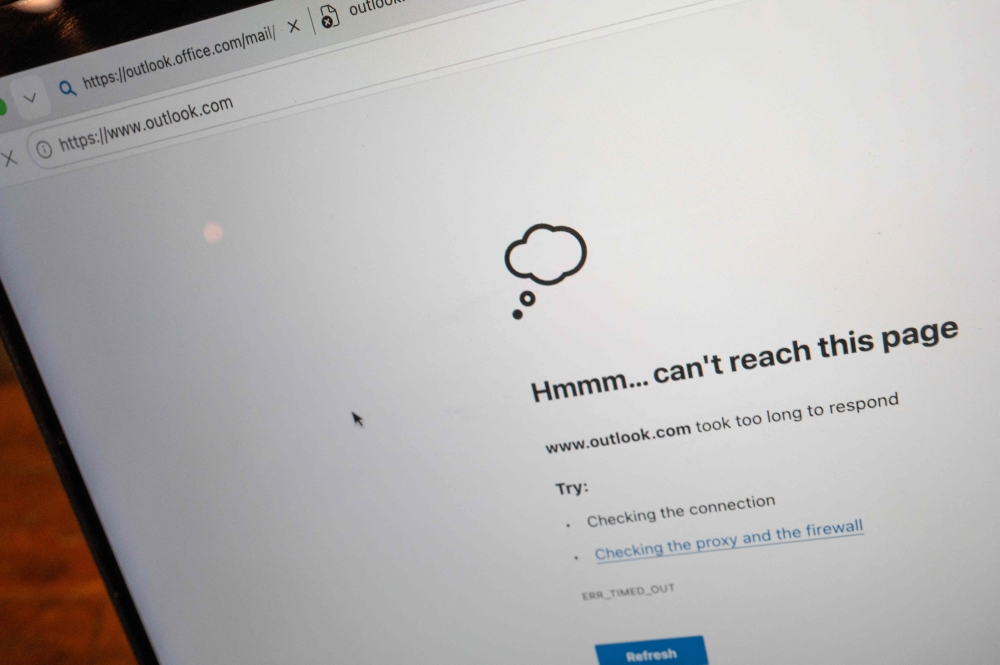
该公司又花了15个小时排除故障,然后才开始部署修复问题。同时,由于电子邮件收件匣无法载入、Teams会议邀请消失,众多使用微软系统的企业和政府客户的工作都陷入停滞,员工们只能依赖电话和纸笔进行沟通。
严重冲击用户信任
这次大当机冲击到用户对微软的信任,也提醒人们过度依赖单一技术供应商的风险。微软负责办公室软体的副总裁拉曼那(Charles Lamanna)当地时间周一(16日)在微软的X平台上发文,就这次服务中断事件致歉,并提供更多细节内容。
拉曼那披露,之前没有发现这个漏洞,是因为该公司在实验室中模拟的流量模式和硬体,并不能反映伺服器后来遇到的真实世界条件。
微软的测试通常专注于较旧和较弱的系统,以评估更新是否会使该公司云端中最薄弱的一环出现故障,而导致伺服器崩溃的漏洞出现在新硬体上。由于其处理能力更大,破坏力也更大。


